Data Change Management
Jede Organisation führt Datensätze über Dinge: Kunden, Lieferanten, Produkte, Verträge, Standorte. Ich nenne sie Informationsobjekte. Die Datensätze veralten schneller, als die meisten Teams erwarten, weil sich die Dinge, die sie beschreiben, ständig ändern:
- Ein Unternehmen ändert seinen Namen, fusioniert, spaltet sich auf oder geht insolvent.
- Ein Produkt bekommt eine neue Version, einen neuen Preis oder einen neuen Eigentümer.
- Ein Standort wird eröffnet, umgenutzt oder geschlossen.
- Ein Vertrag geht auf eine andere Partei über, und ein Ansprechpartner wechselt den Arbeitgeber.
Wie gehen Sie mit diesen Änderungen um? Was ist mit den Änderungen, die niemand bemerkt oder erst ein Jahr später? Wie viele aktive Lieferanten hat das Unternehmen heute, wie viele hatte es vor fünf Jahren, und wie viele wird es im nächsten Jahr haben? Was, wenn zwei Quellen über dasselbe Objekt Verschiedenes sagen? Und wer entscheidet, ab wann ein Lead als Kunde gilt?
Was veraltete Daten kosten
Veränderung hört nie auf. Manchmal kommt sie abrupt, meistens langsam, und sie folgt in allen Branchen, in denen ich gearbeitet habe, ähnlichen Mustern. Die meisten Werkzeuge, die die IT dafür nutzt, wurden für Daten gebaut, die einmal erfasst und danach nur noch gelesen werden. Ein Unternehmen, das den Umgang mit Änderungen nicht automatisiert, arbeitet mit unvollständigen, veralteten oder falschen Informationen. Anbieter, die solche Informationen als Marktdaten verkaufen, verärgern die Kunden, die dafür bezahlen: Die Qualität ist schlecht, und viele Daten fehlen.
Was Datenbanken auslassen
Data Change Management ist mein Name dafür, Änderungen als Teil der Daten zu behandeln. Eine Änderung ist so wichtig wie der Wert, den sie ersetzt. Datenbanken halten meist den besten verfügbaren Stand von heute, und zwar für die Stelle, die die Daten verwaltet. Selten nutzt man sie, um
- ein Schema ohne Programmierung zu ändern,
- jede Änderung an jedem Datensatz zu versionieren,
- die Menschen, die es besser wissen, die Daten aktualisieren, bewerten und korrigieren zu lassen,
- die Daten so zu zeigen, wie sie zu einem anderen Zeitpunkt als heute standen.
Diese vier Punkte sind der Kern von Data Change Management. Eine Änderung wird so erfasst und gezeigt, wie sie zu einem bestimmten Zeitpunkt und aus einer bestimmten Sicht am besten bekannt war.
Identität ohne statischen Schlüssel
Ein Ergebnis dieser Arbeit betrifft den Austausch von Daten. Statische Primärschlüssel sind der übliche Weg, Datensätze zwischen Systemen auszutauschen. Den Anforderungen der Veränderung genügen sie nicht, weil sich fast jede Information über ein Objekt jederzeit ändern kann. Ein verlässlicher Austausch braucht ein System, das auf statische IDs verzichten kann und andere Wege bietet, Datensätze zu identifizieren und einander zuzuordnen.
Das Konzept dahinter
Ich habe das Konzept aus der langen Beobachtung entwickelt, wie Veränderung abläuft, und aus Ideen der Evolutionsforschung. Der Speicher ersetzt die üblichen Datenbanktabellen durch kleine Einheiten nach dem Vorbild der Genetik. Ein Nukleotid enthält ein Datenpaar zu einem Objekt: einen Wert mit seinem Typ, seiner Quelle und dem Commit, der ihn geschrieben hat. Ein Strang nach Art der RNA, des einfachen Trägers, speichert die Daten. Ein Strang nach Art der DNA, des komplexen, enthält die Verarbeitung: Trigger, Prozesse und Logik.
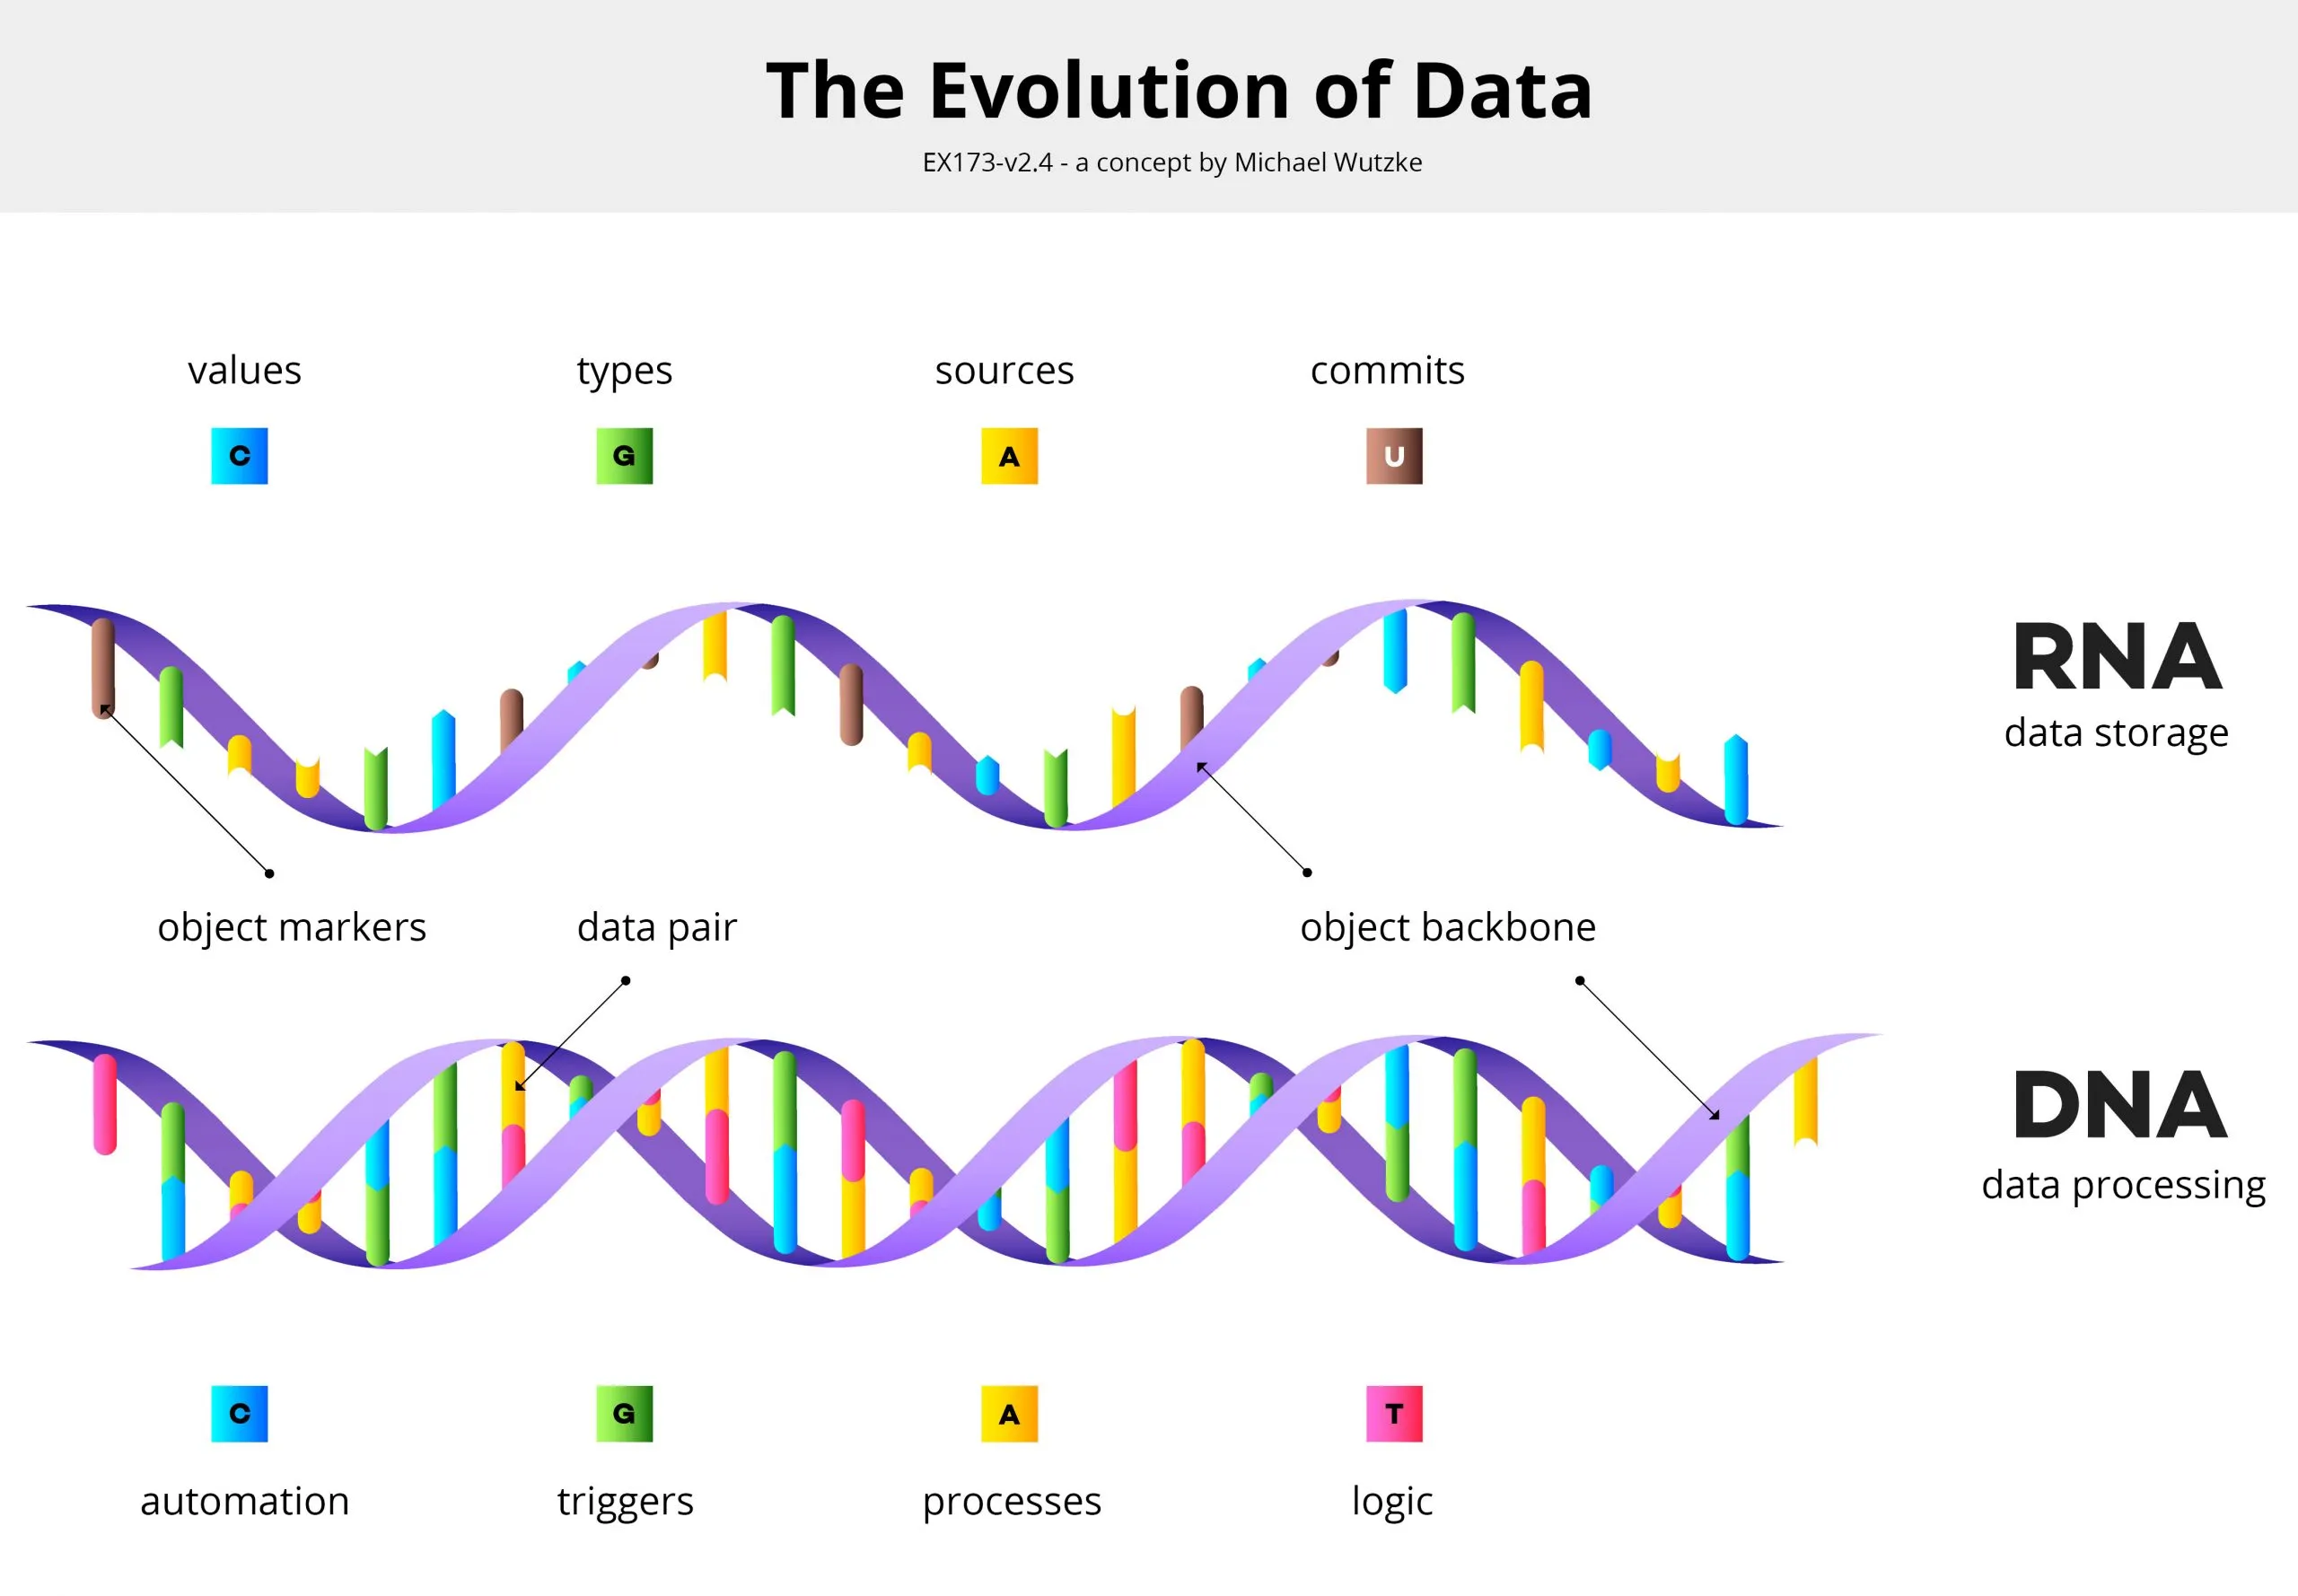
Eine radikal einfache Speicherschicht erlaubt beliebige Komplexität in den Objekten, die sich auf ihr entwickeln. Der Speicher war der leichte Teil des Projekts. Schwer war der erste Satz an Funktionen: Einige Komponenten braucht das System, um überhaupt zu funktionieren, und sie hängen von anderen Komponenten desselben Systems ab. Organismen haben dasselbe Problem: Es muss einen Ursprung geben.
Ergebnisse
Ziel des Forschungsprojekts waren verlässliche Daten, die sich selbst organisieren. Das Projekt ist abgeschlossen. Seine Ergebnisse laufen im Produktivbetrieb auf einer Informationsplattform, und ich entwickle sie dort weiter. Jede Änderung an einem Datensatz ist eine Version. Jeder Fakt trägt seine Quelle, den Zeitpunkt, zu dem er beobachtet wurde, und die Zeit, in der er zutraf. So beantwortet die Plattform, was zu einem beliebigen Datum bekannt war und von wem. Die Muster der Veränderung ähneln sich über Branchen hinweg, deshalb passt das Modell zu Versicherungen, Finanzen und jedem anderen Bereich mit langlebigen Objekten. Die Seiten unter Forschung beschreiben den aktuellen Stand Teil für Teil.
Suchanfragen zu diesem Thema
- Data Change Management
- Data Change Management Process
- Data Change Management Best Practices
- Data Governance Change Management
- Change Data Capture
- Change Data Capture (CDC)
- Stammdatenmanagement
- Stammdatenmanagement Definition
- Stammdatenpflege
- Stammdaten
- Master Data Management
- Master Data Management deutsch
- Data Versioning
- Data Versioning in Database
- Versionierung Datenbank
- SQL Datenbank Versionierung
- Historisierung von Daten
- Historisierung Datenbank
- Historisierung IT
- bitemporale Daten
- bitemporale Datenbank
- temporale Datenbank
- Slowly Changing Dimensions
- Slowly Changing Dimensions Type 2
- Data Lineage
- Data Lineage deutsch
- veraltete Daten
- Datenqualität
- Datenqualität verbessern
- Datenqualitätsmanagement
- Datenqualität Dimensionen
- Dublettenprüfung
- Entity Resolution
- Primärschlüssel
- Audit Trail
- Schema Evolution